長編トーク:Difyプラグインは AIエージェントアプリ開発をどう支えるのか?
Dify 1.0 のプラグイン体系:リモートデバッグ、Endpoint、リバース呼び出し、そして SSH・ゲートウェイ・データベース・RAG・エージェント戦略・MCP への実装。
このページの内容
みなさん、こんにちは。Dify でテクニカルドキュメントエンジニアを務めている Allen です。主に Dify のヘルプドキュメントと、エンタープライズ版のドキュメントの整備を担当しています。
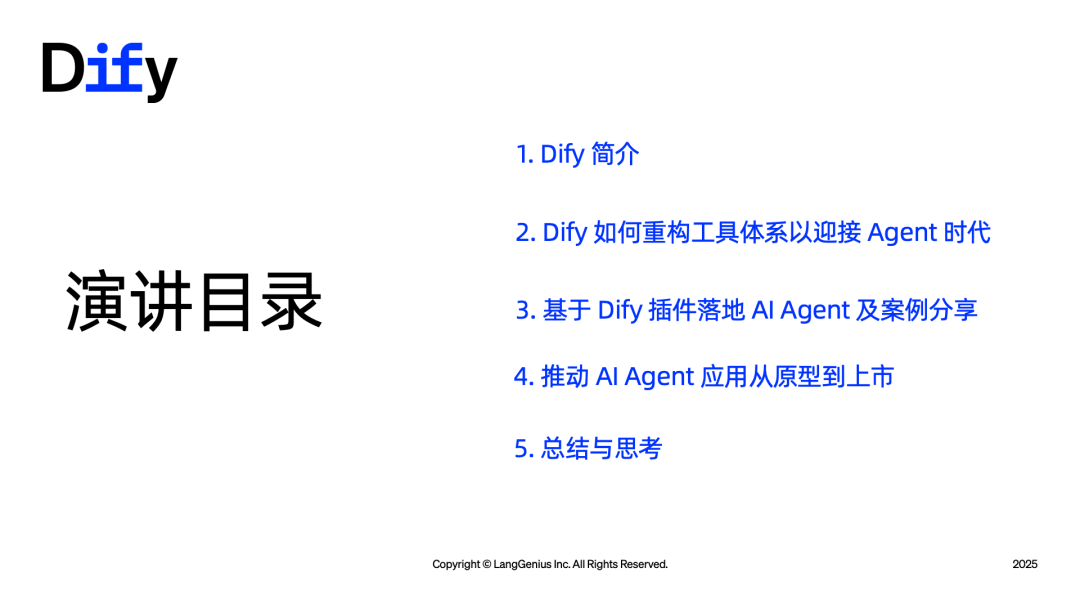
今回のテーマは、Difyプラグインエコシステムの実践:エージェントアプリ開発の新しいパラダイムです。内容は五つのパートに分かれています。Difyとは何か、変化し続けるエージェント開発にどう対応してきたか、プラグインが複雑なエージェントに何を提供できるか、いくつかの実例、そしてアプリをどのように本番環境へ投入するか、です。
#Difyの紹介
AIの知能を、水道や電力網のような新しい生産資源にたとえてみましょう。ChatGPTが爆発的に流行し始めたころ、開発者たちは何度も車輪の再発明をしていました。APIをどう接続するか、ナレッジベースをどう処理するか、といったことです。Difyはこうした背景の中で生まれました。ワークフローのオーケストレーション、RAG、エージェントの構築、マルチモデル管理、そして可観測性を、一つのオープンソースのソリューションにまとめたのです。
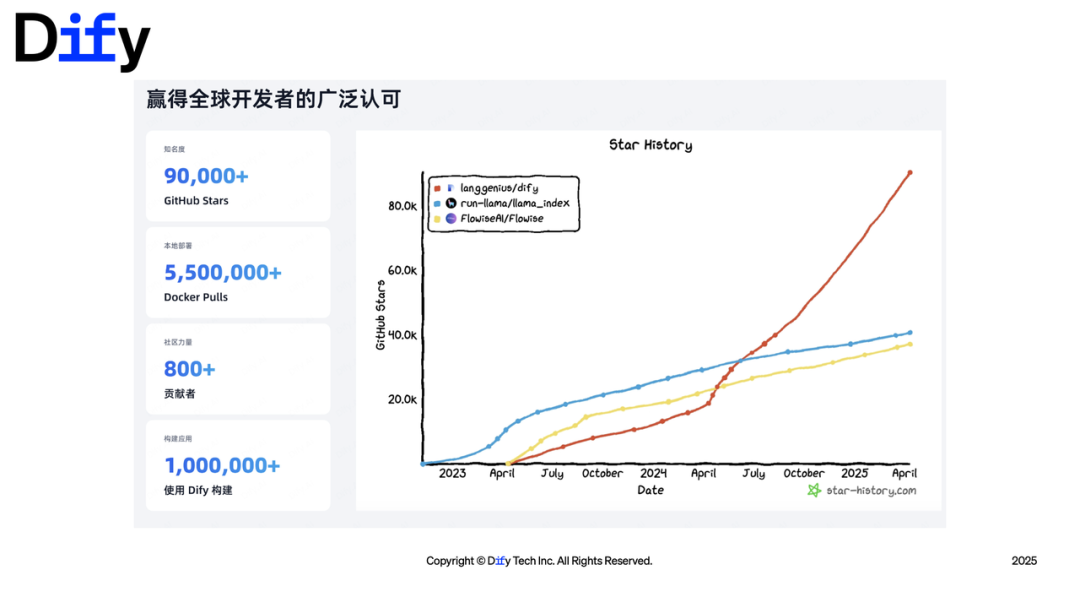
この二年で、GitHubのスターは10万を超え、世界のオープンソースプロジェクトのトップ50に入りました。
 深く使っているユーザーの多くは、厳密な意味での開発者ではありません。財務、オペレーション、マーケティングや営業の人たちです。この変化の中で、ビジネスの人たちが取り残されてはいけません。使いやすいエージェントアプリは、日々の課題への洞察から生まれます。Difyがやりたいことは、技術的なハードルを下げ続けることです。
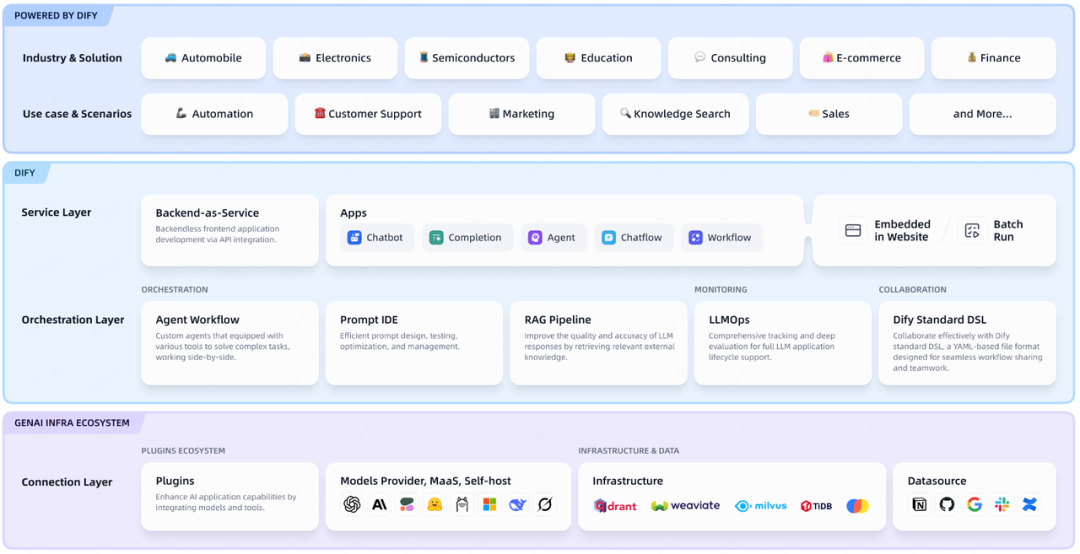
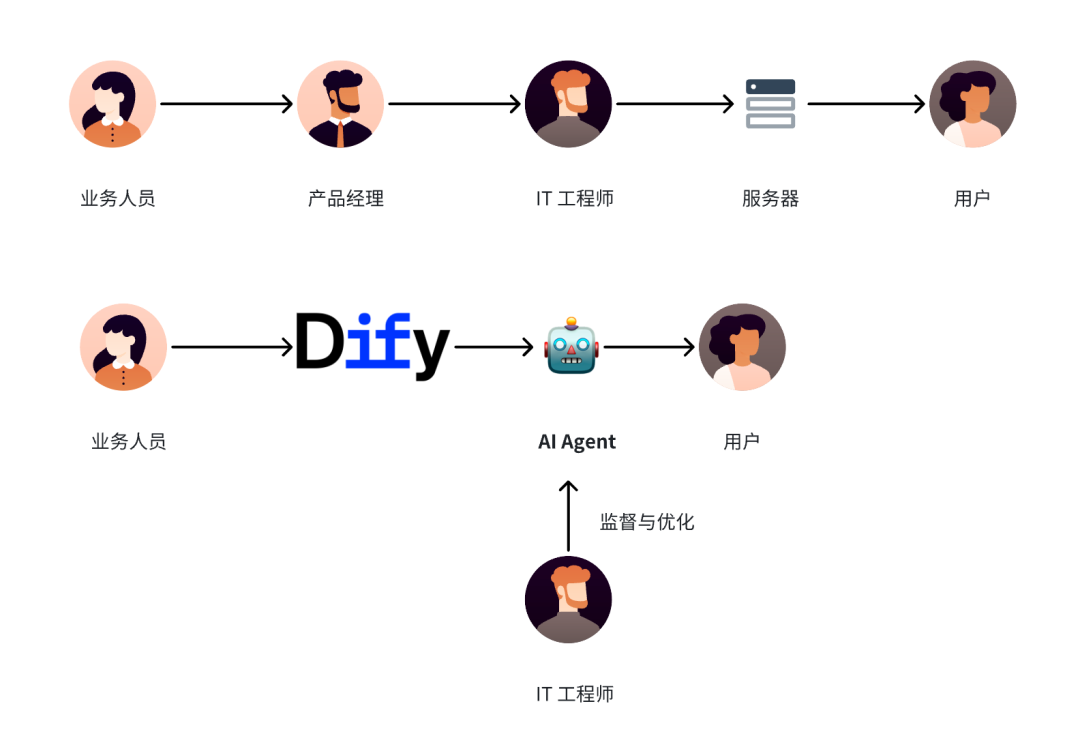
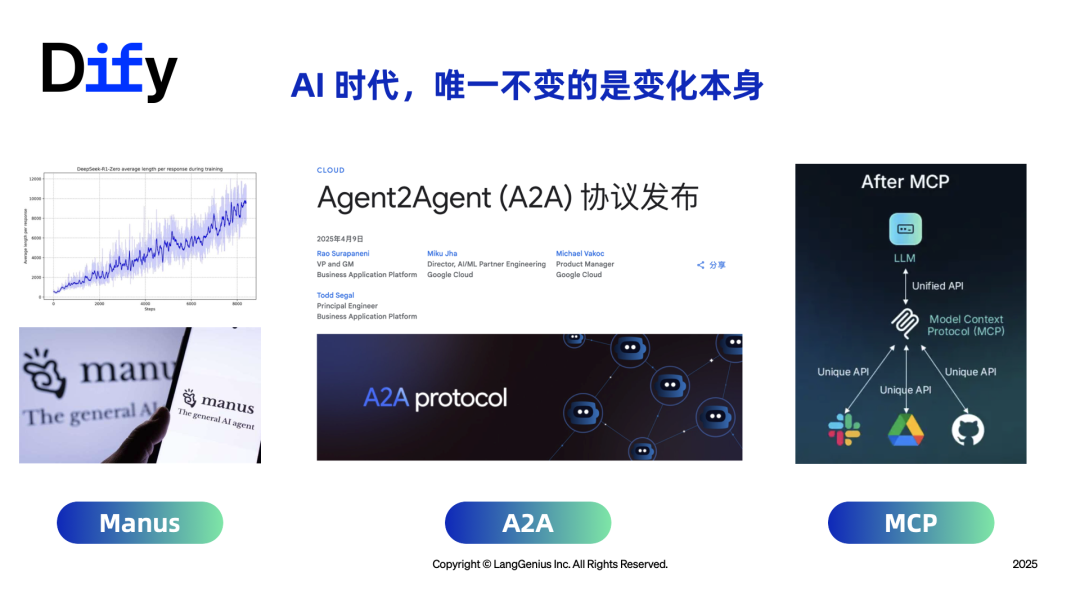
技術の移り変わりは速く、DeepSeek、Deep Research、Manus、MCP、A2Aが次々と登場しています。もはや、LLMのAPIを一つつなぐだけでストーリーを語れる時代ではありません。エージェントにはマルチモーダル、ネットワーク接続、OCR、そしてナレッジベースの正確さが求められています。開発者にとっては、技術が変わり、シナリオが変わり、そして時間とリソースはいつも限られています。プラグイン体系は、開発をレゴブロックのように組み合わせられるようにするためにあるのです。
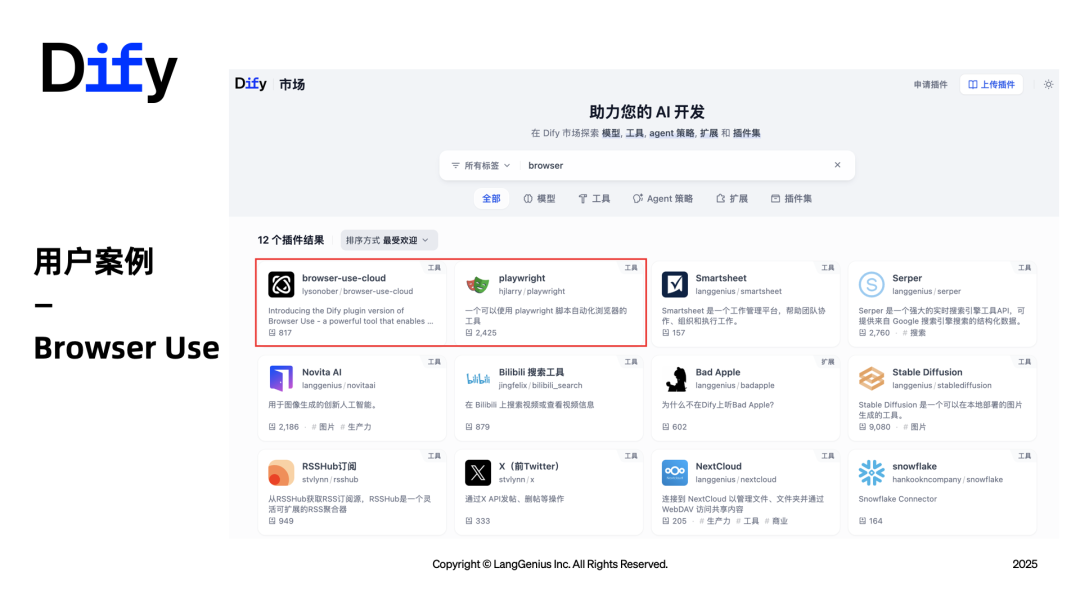
四つの例を挙げます。
Browser Use。 日本のユーザーからの貢献です。ウェブページの重要な情報を特定します。たとえば、問い合わせフォームの項目を見つけて、そのURLを持ち帰ります。マーケットプレイスで「Browser」と検索するだけで使えます。
Deep Researchの再現。 主要なフローチャートを把握していれば、ノードを組み合わせて、見たままを編集できるLLMアプリを作れます。
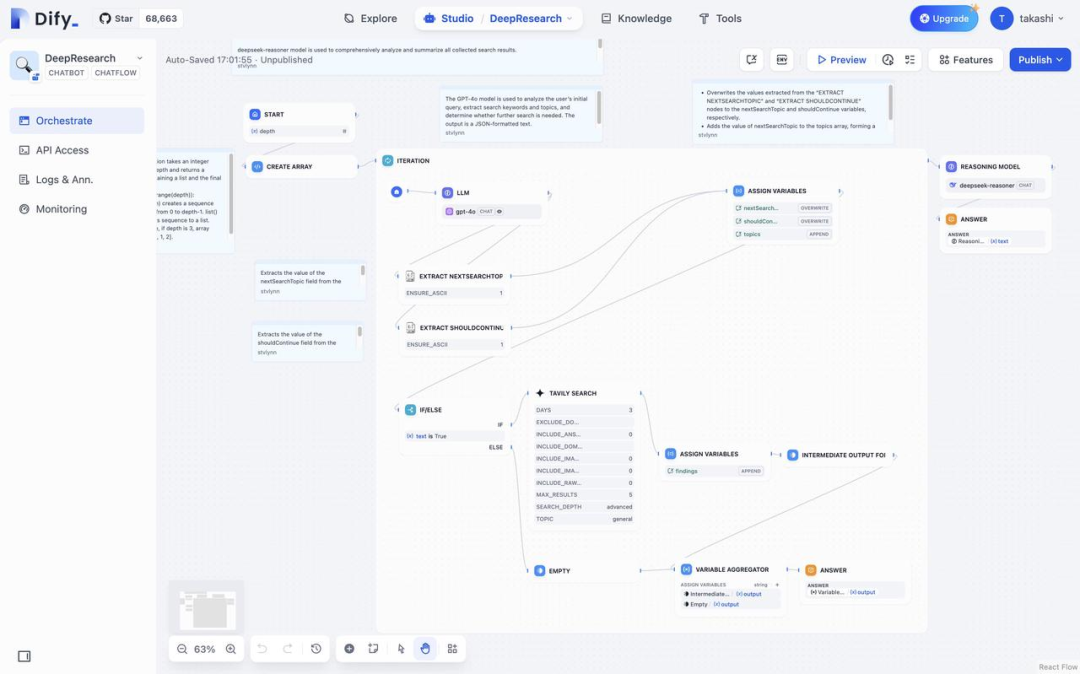
SSHプラグイン。 指示を入力すると、自動的にサーバーにログインし、ウェブページをデプロイします。開発の過程は後ほど詳しく見ていきます。
動画生成。 APIをプラグインに変換したものです。このプラグインは私が作りました。
私たちは、Difyを単にLLMアプリの基盤にとどめず、AI機能を呼び出すためのオペレーティングシステムにしたいと考えています。初期には、ツール呼び出しの入り口は一つしかなく、APIへの依存も大きかったため、エージェントの速いペースにはもはや追いつけませんでした。
#Difyはどのようにツール体系を再構築したか
#旧体系の問題
コミュニティからは「いつ〇〇のモデルに対応するのか」とよく聞かれます。多くの場合、変わるのはパラメータだけなのに、パッケージを作り直して新しいリリースを出す必要がありました。以前は、Difyに外部の機能を貢献しようとすると、APIツールを一つ追加するだけでも、ソースコード全体をローカルにデプロイしなければなりませんでした。
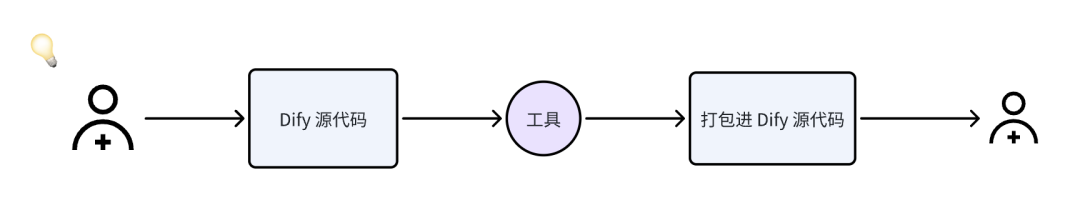
問題は三つにまとめられます。
- コードの強い結合。 モデルやツールを追加するのが面倒で、エンジニアリング上の依存関係が重く、バージョン管理も難しいものでした。
- ユーザーのニーズを閉じたループで解決できない。 IMに接続するには、Difyの外側に別途Webhookの層を作る必要がありました。
- カスタマイズ可能なモジュールが固定されている。 PDF解析やRAGなどを柔軟に調整できませんでした。
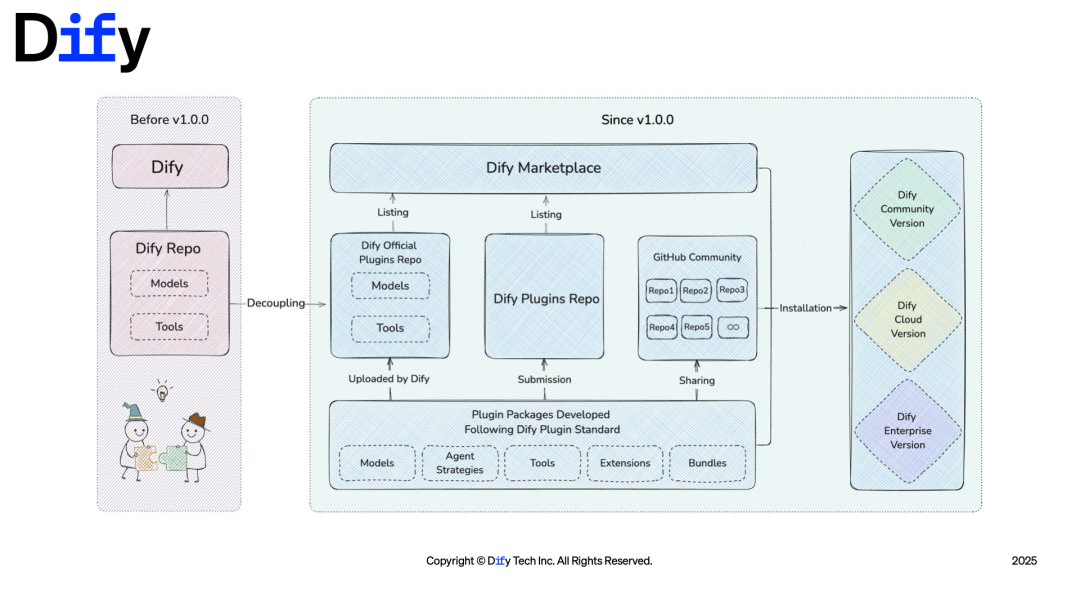
そこで、ツールとモデルを、独立してインストールできるプラグインに分割することにしました。文書解析やOCRもプラグイン化しました。Dify内では閉じたループを作れないシナリオについては、オープンなインターフェースを通じて外部システムと接続するようにしました。
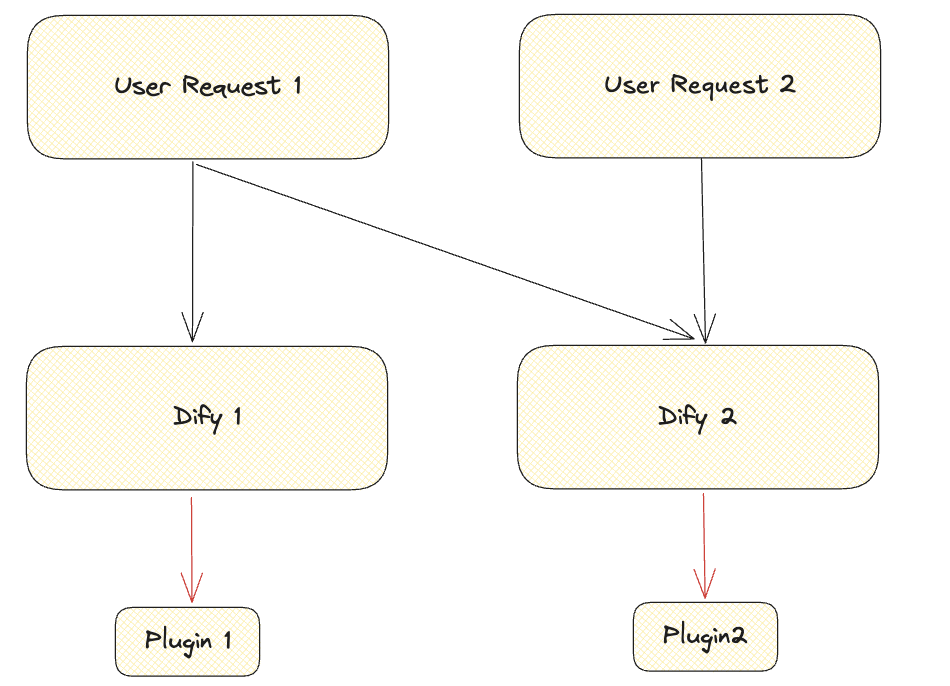
エンジニアリングの面では、すぐにいくつもの問題にぶつかりました。複数のワークスペースの間でツールを共有できないこと、プラグイン環境の一貫性を保つこと、クラウド上で数万のプラグインを動かすランタイムのコスト、コードを変更するたびに再パッケージが必要なこと、そしてプラグインは長時間HTTPサービスを動かしてWebhookを待ち受けるべきなのか、という問題です。
#三つの重要な設計
リモートデバッグ。 デバッガーとランタイムを分離し、ランタイムの側から能動的にDifyへ接続します。ローカルのプラグインはDifyと長いコネクションを張り、インストール済みとして扱われ、デバッグモードとして表示されます。リクエストは長いコネクションを経由して転送されます。難しいのは、長いコネクションは状態を持つのに対し、Difyのサービスはステートレスであることです。Kubernetesのロードバランサーは、リクエストを間違ったPodへ送ってしまうことがあります。そこで後から、トラフィック転送によって解決しました。
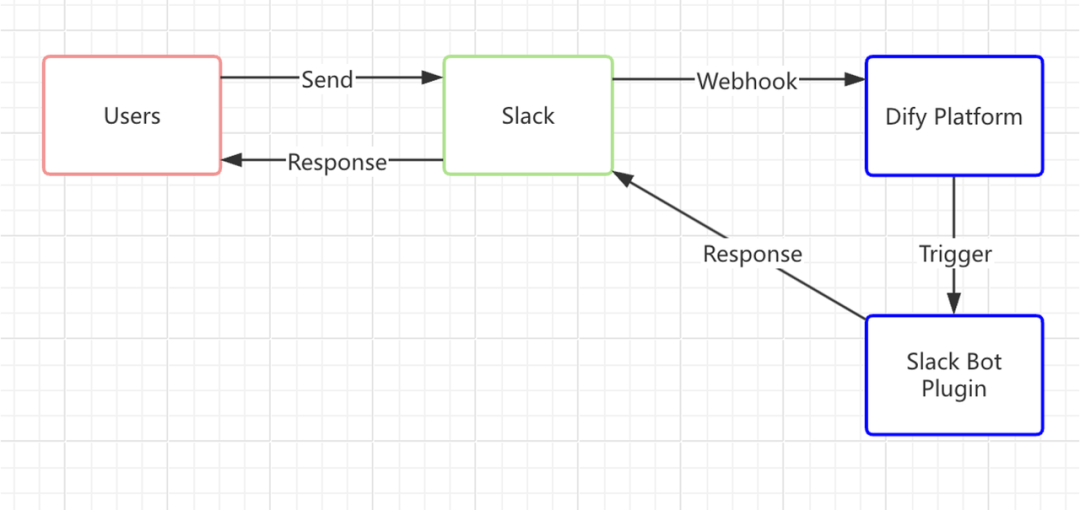
Endpoint。 DifyがIMやオフィスソフトのWebhookを受け取れるようにする仕組みです。プラットフォームがランダムなURLを生成し、HTTPの転送を自ら担当します。プラグインは、転送されてきたリクエストを処理するだけでよく、それぞれのプラグインが長時間サーバーを動かし続ける必要はありません。
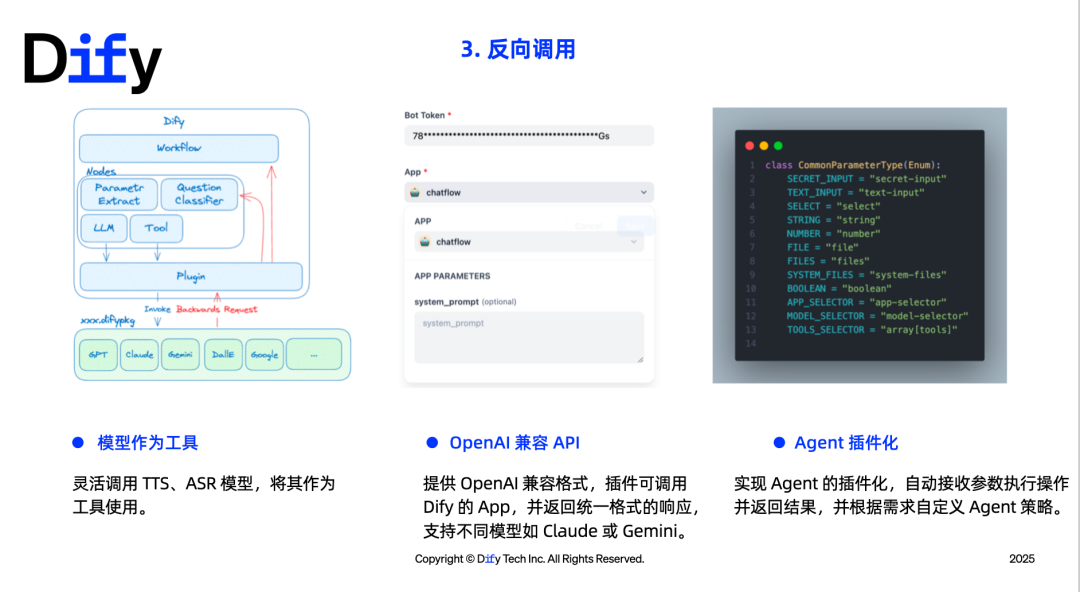
リバース呼び出し。 プラグインは、Dify内部で認証済みのモデル、ツール、またはアプリを呼び出すことができます。用途は、外部のナレッジベース(LlamaIndexのAgentic RAGなど)、OCR・ASR・TTSをツールとして使うこと、Endpointを使ってOpenAI互換のAPIを提供すること、そしてエージェント戦略をプラグイン化することなどです。
#アーキテクチャの要点
SaaS版はサーバーレスに似た弾力性を採用し、AWS Lambdaを選びました。デバッグモードでは、Redisのハッシュマップで接続状態を管理しています。クラスターはIPプールを維持し、投票によって到達可能性を確認します。Masterノードは、終了したPodをクリーンアップします。
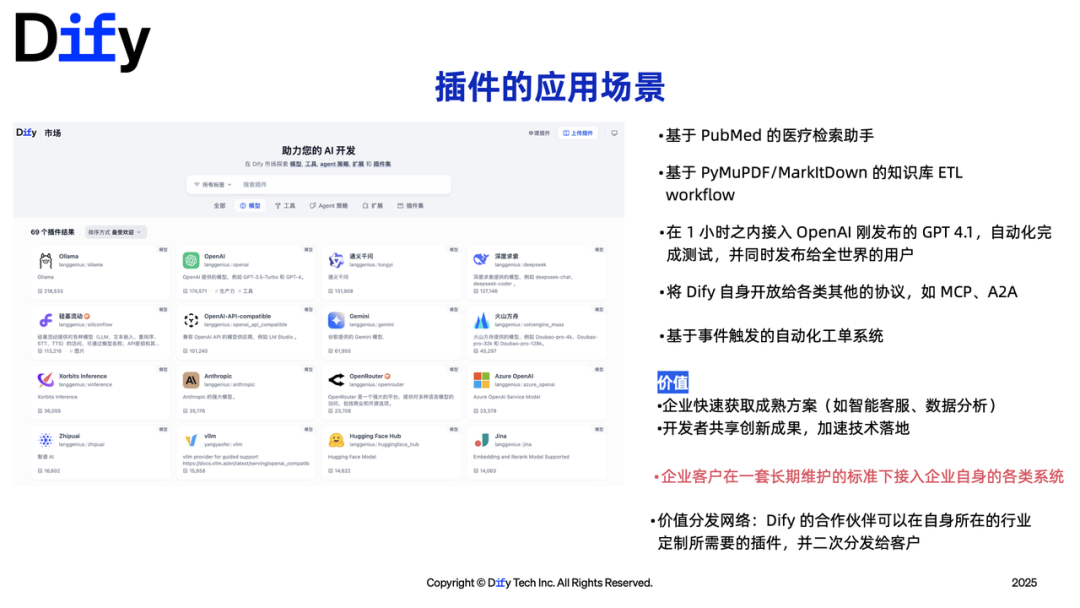
Dify 1.0 の答えは、Chrome、VS Code、WordPressのように、オープンソースのプラグインエコシステムに頼ることです。ユーザーは公式機能をいつまでも待つ必要がなく、よくできたプロジェクトはコミュニティに見つけてもらえます。プラグインマーケットプレイスは公開後すぐに120を超えるサービスに達しました。MCPやA2Aといった新しいプロトコルも、プラグインとして接続できます。当時すでに予告していたのは、DifyがMCPをツールとして接続できるようにし、構築したアプリをMCPサーバーとして公開できるようにすることでした。
#プラグインでエージェントアプリを実装する方法
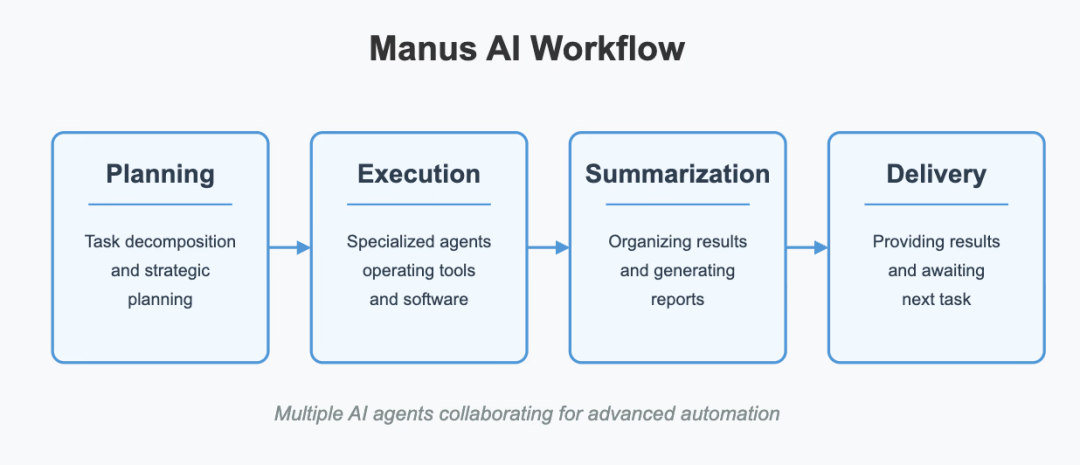
エージェントは、インテリジェントな意思決定と自律的な実行を追求するもので、RPAの固定されたフローとは異なります。現在の課題としては、安定性の低さ、認識のずれ、コンテキストの管理の難しさ、検証できない結果、そして複数のシステムをまたいで動作する能力の限界などがあります。
Difyプラグインの利点は次のとおりです。
- 開発コストを下げる。 標準的なインターフェースとスキーマにより、モデルが呼び出し方を理解できます。呼び出すタイミングはモデルに任せるため、制御ロジックを書く量が減ります。一度開発すれば、多くの場所で再利用できます。
- モジュール式に進化させる。 単一のプラグインと簡単なプロンプトから始め、徐々に機能を追加できます。それぞれのプラグインは単独でデバッグできます。
#SSHプラグインの書き方
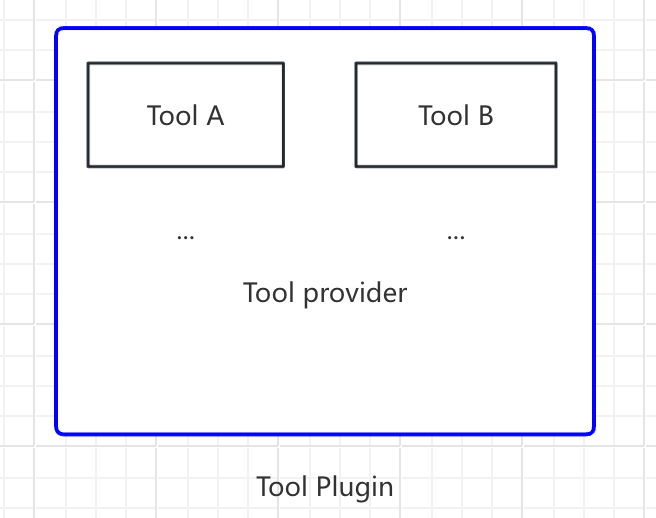
ツールタイプのプラグインから始めることをおすすめします。構造はシンプルです。まずツールプロバイダーを定義し、次に実行可能なアクションを定義します。人間がサーバーにログインして行う操作には、すべてプラグイン内に対応するアクションが必要です。ホスト、ポート、パスワード、コマンドの実行などです。
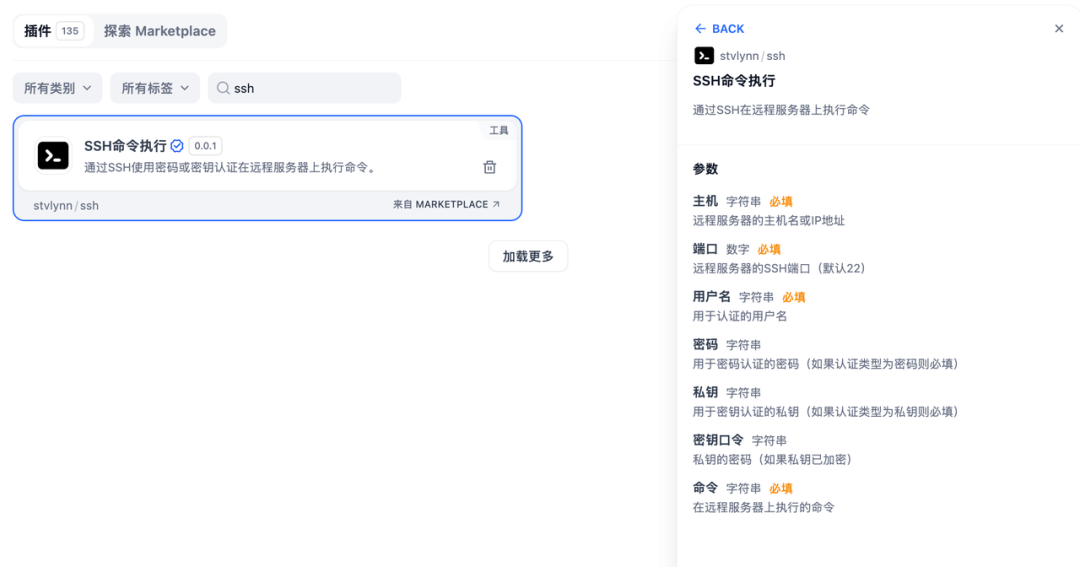
手順は次のとおりです。
- 新しいプロジェクトを作成し、多言語対応を含めて
manifest.yamlを記入します。 - プロバイダーの名前と説明を定義します。
tools/の下に、アクションごとに一つのPythonファイルを作成し、関数でパラメータを処理します。.envにリモートデバッグのアドレス(SaaS版またはコミュニティ版)を記入します。Difyの全体をローカルにデプロイする必要はありません。- コマンドラインで
.difypkgファイルとしてパッケージ化します。apkのような仕組みで、非中央集権的に配布できます。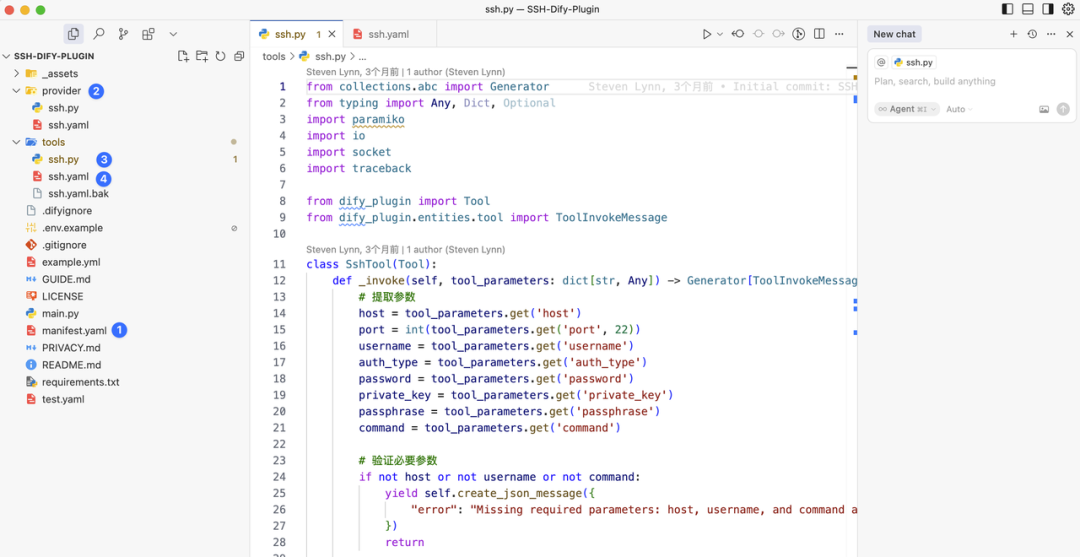
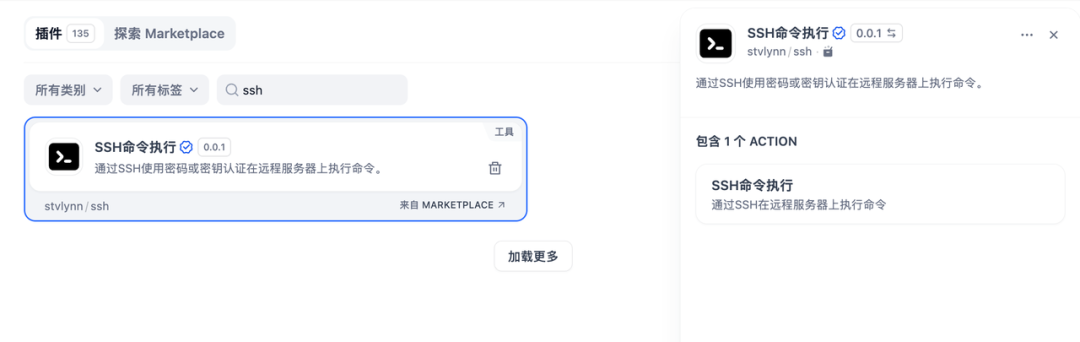
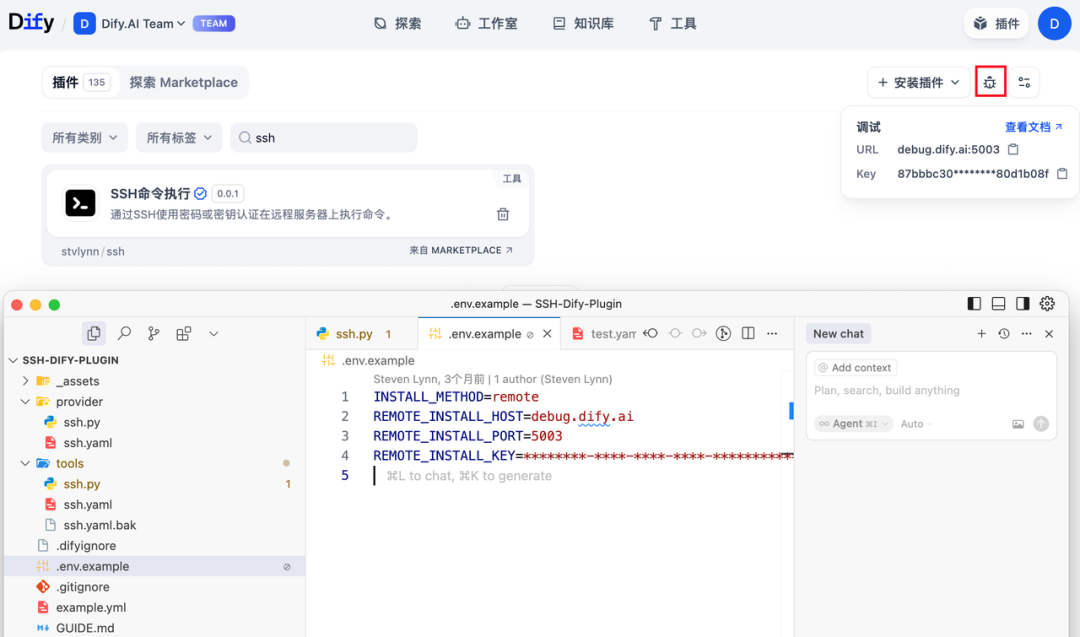
多くのインフラベンダーのAPIドキュメントは非常によくできています。足りないのは、すっきりした入り口です。APIをDifyプラグインに変換すれば、エコシステムに参加できます。
#プラグインのセキュリティ
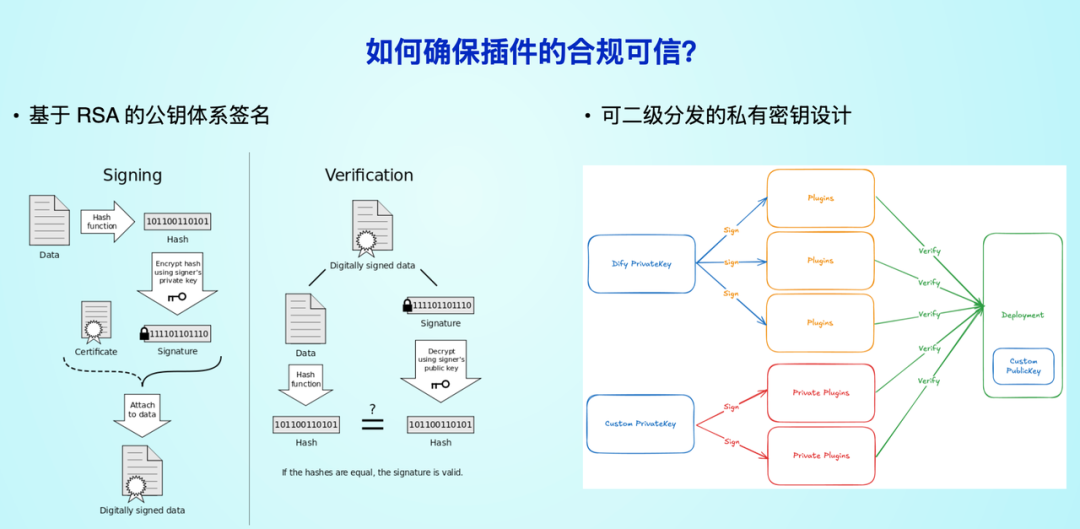
セキュリティは、厳格なサンドボックスではなく、主に署名に頼っています(サンドボックスを使うと、多くの依存関係がインストールできなくなってしまうからです)。人の目によるレビューのあと、秘密鍵で署名し、認証済みとしてマークします。署名のないプラグインは、ユーザーが設定を変更しない限り、デフォルトではインストールできません。
#五つの事例
Difyには五種類のプラグインがあります。モデル、ツール、エージェント戦略、Extension、そしてBundleです。
#1. DifyをLLM APIゲートウェイにする
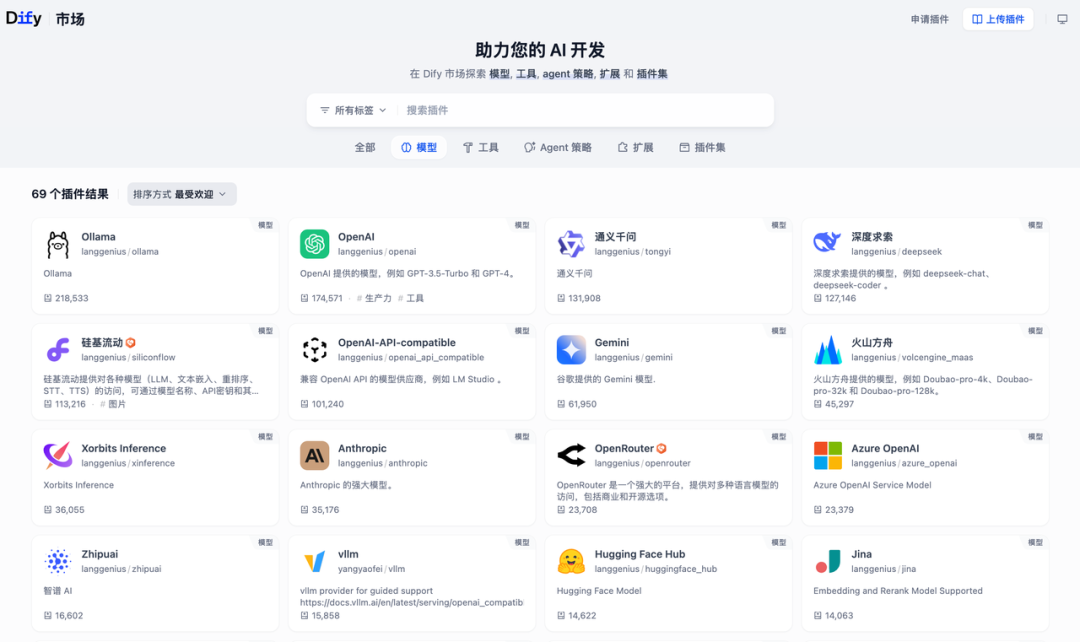
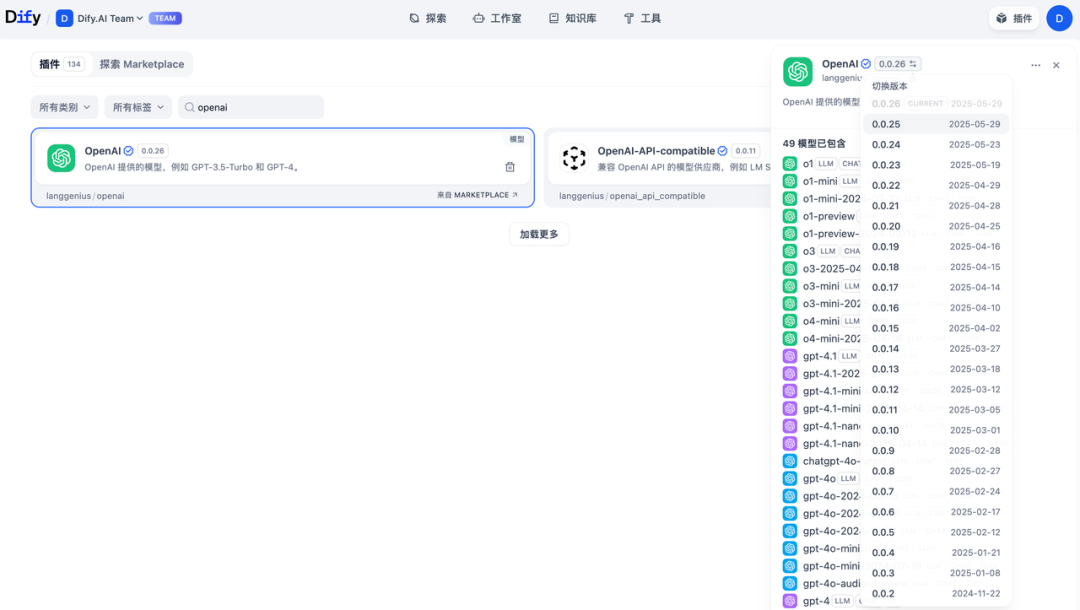
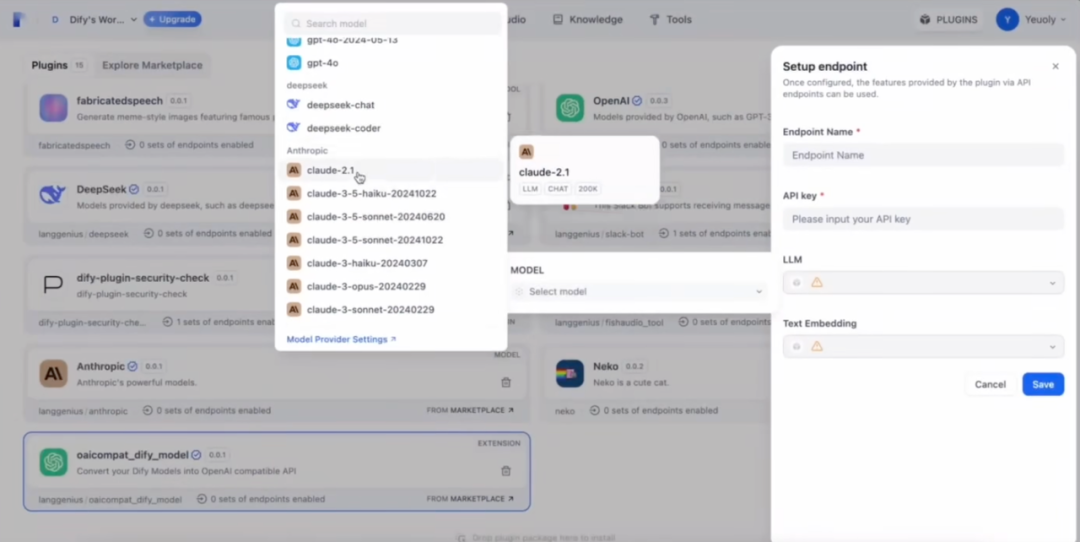
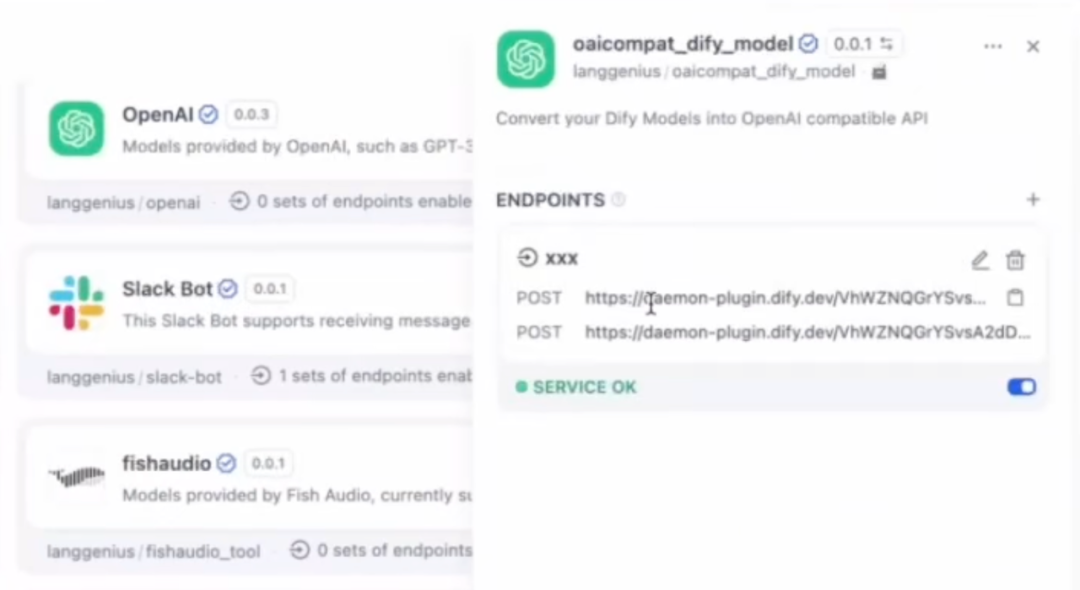
ユーザーはもともと、多くのモデルのキーをDifyに保存しています。プラグイン化したことで、モデルプロバイダーは最も更新頻度の高いプラグインの種類になりました。リバース呼び出しによって、EndpointプラグインはDify内でホストされている任意のモデルを、OpenAI互換の形式で公開できます。自社開発のモデルも、同じ呼び出し方式にまとめることができます。
#2. データベースプラグイン
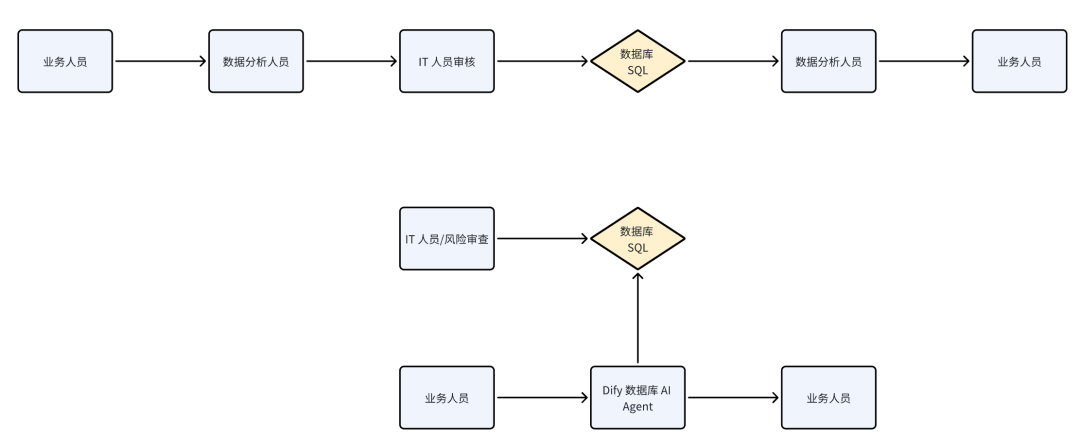
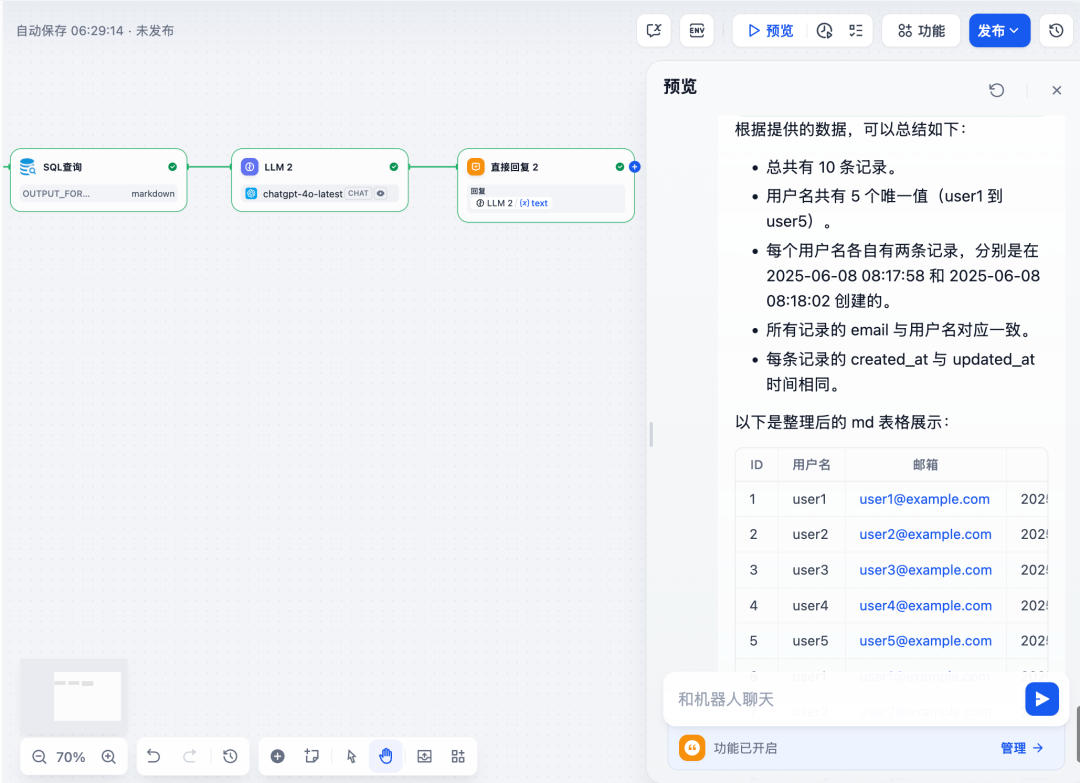
ビジネスの人がデータを必要とするとき、多くの場合はIT部門の承認が必要で、しかもSQLが書けるとは限りません。読み取り専用のデータベースプラグインを使えば、自然言語でデータを照会できるようになります。リスクはIT部門が管理し、問い合わせはビジネス側が自分で行えるのです。
#3. サードパーティ製RAG
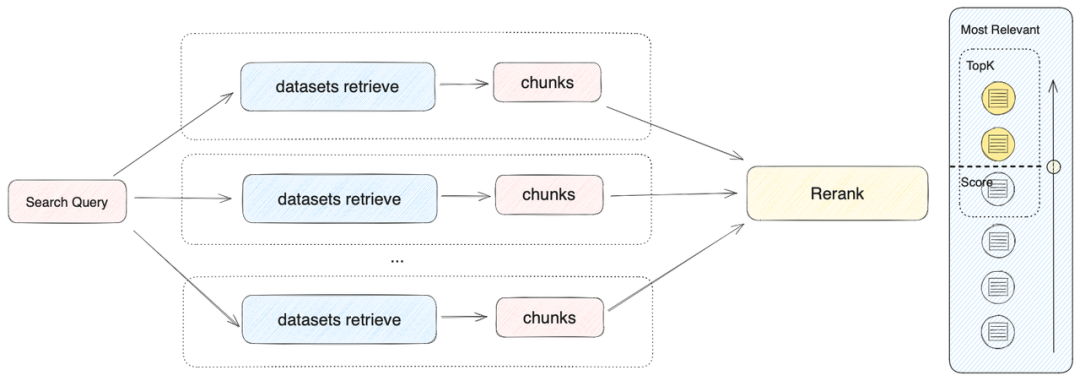
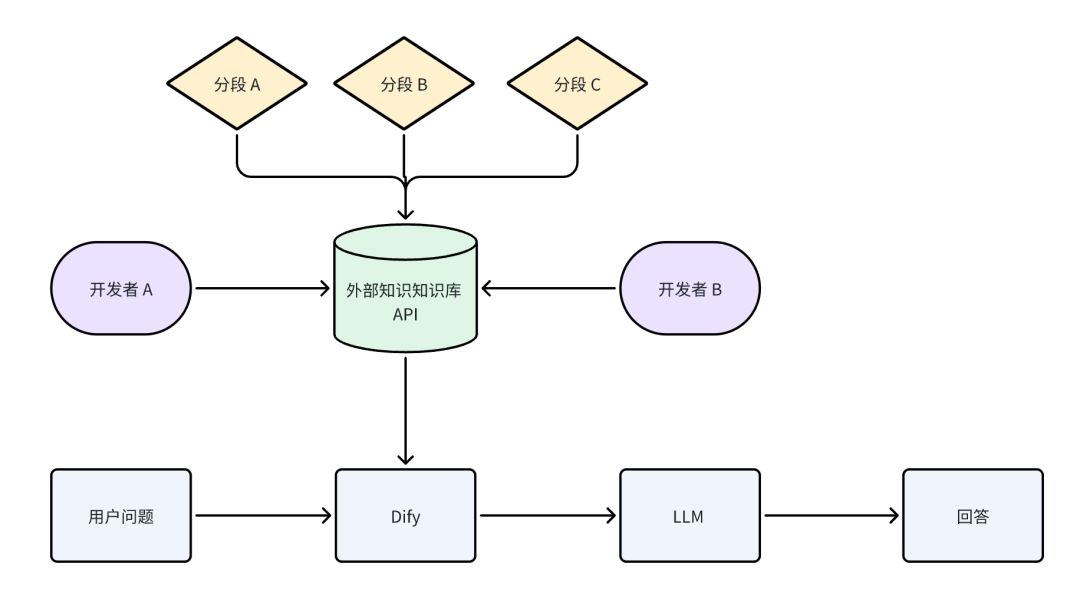
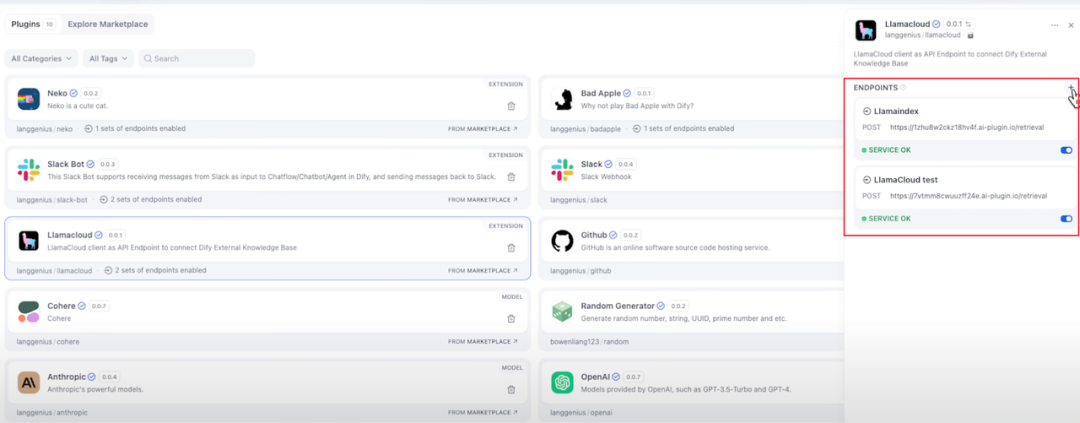
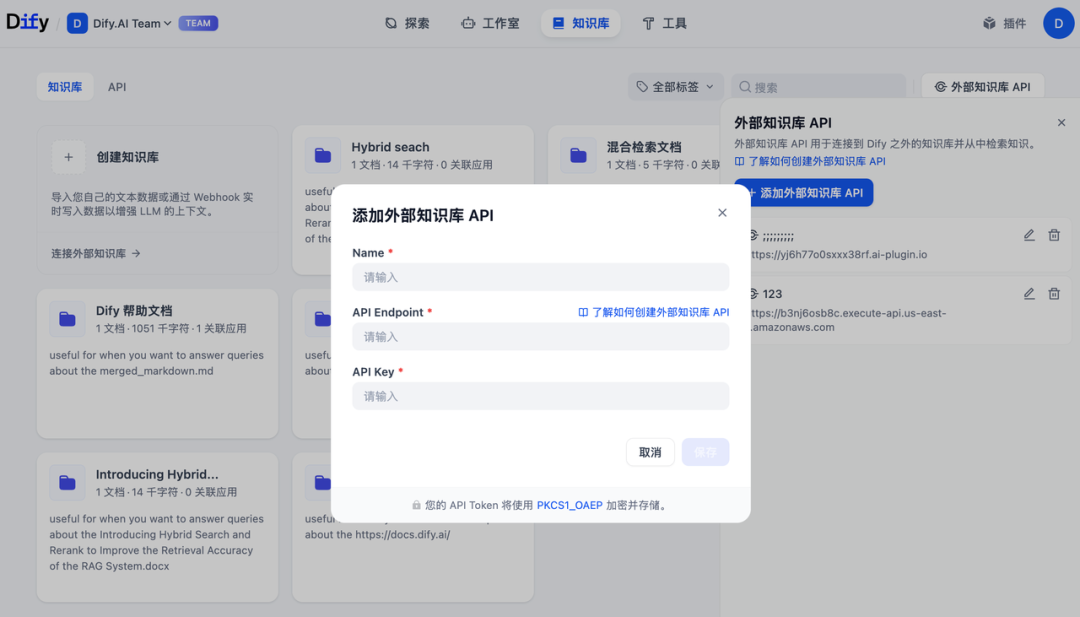
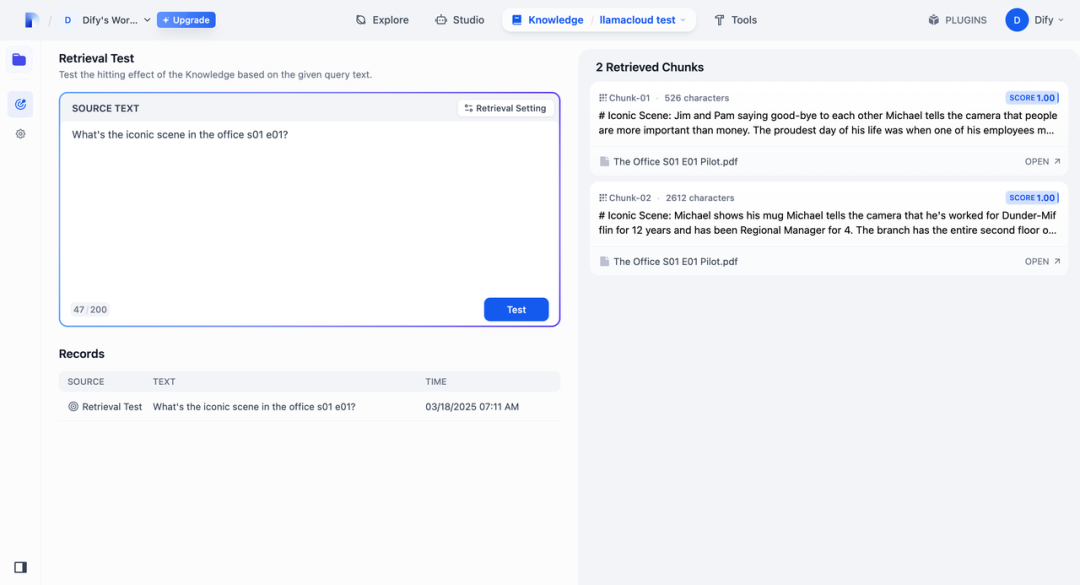
Difyは初期からナレッジベースを備えていましたが、専門的なベクトルデータベースや複雑な文書解析は、他社の製品のほうが強いことが多いものです。外部のナレッジベースのソリューションは、まずAPIを通じて接続されていました。プラグインが登場したことで、よく使われる外部データベースをプラグインとしてパッケージ化でき、開発者がそれぞれ再び接続作業をする必要がなくなりました。このタイプのプラグインは双方向の通信を伴い、Cloudflare Workersに少し似ています。クエリを受け取り、外部のデータベースに問い合わせ、結果をDifyに返します。
#4. 複雑なエージェント戦略
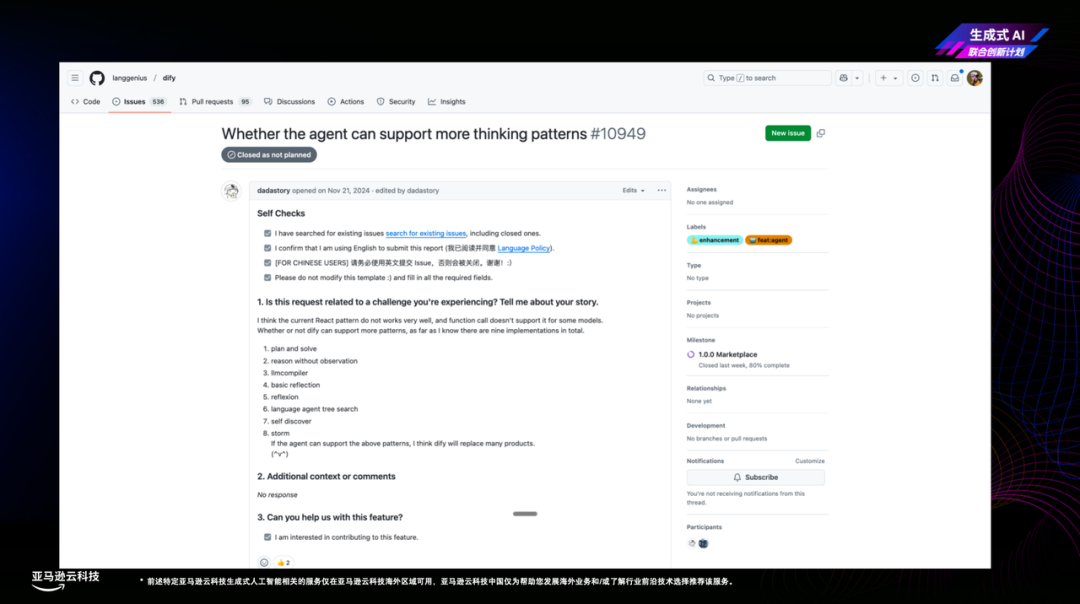
コミュニティは、ReAct、Function Calling、さらにはさまざまな思考連鎖(Chain of Thought)の変種を求めています。エージェント戦略タイプのプラグインを使えば、開発者は独自のストラテジーを実装し、ワークフローのAgentノードにインストールできます。
#5. MCP
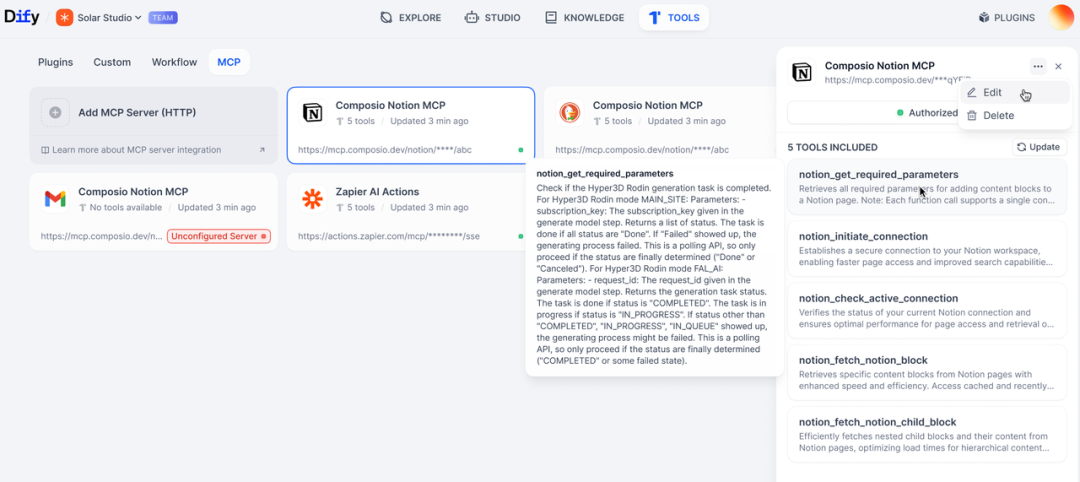
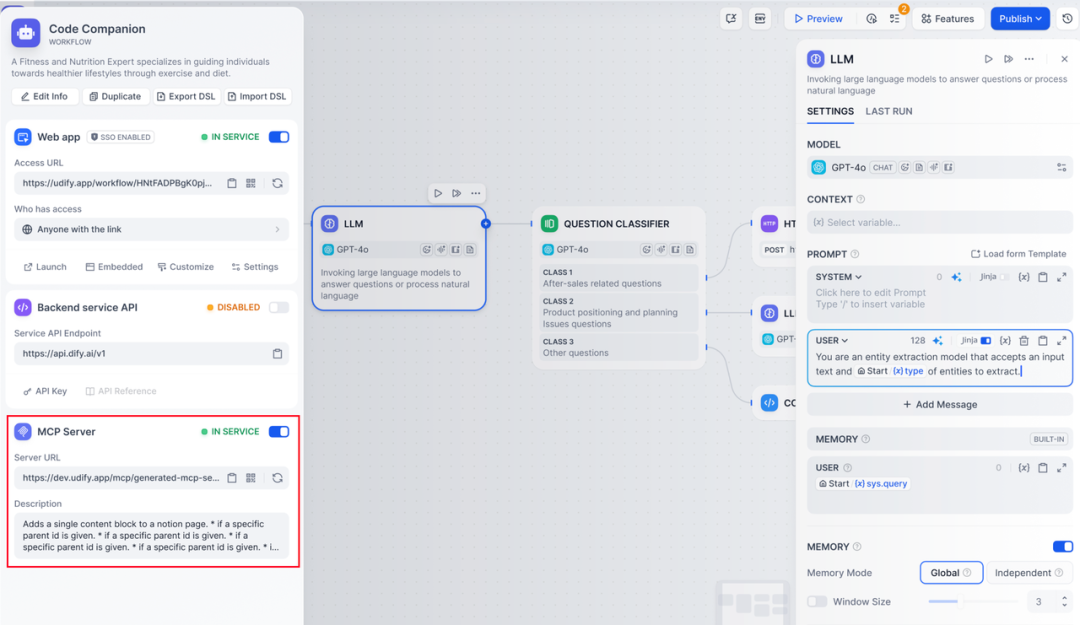
HTTPを通じて外部のMCPサービスに接続します。Difyのアプリは、MCPサーバーとして公開することもできます。そうすれば、構築済みのワークフローをCursorやClaudeから直接呼び出せます。
#プロトタイプからリリースまで
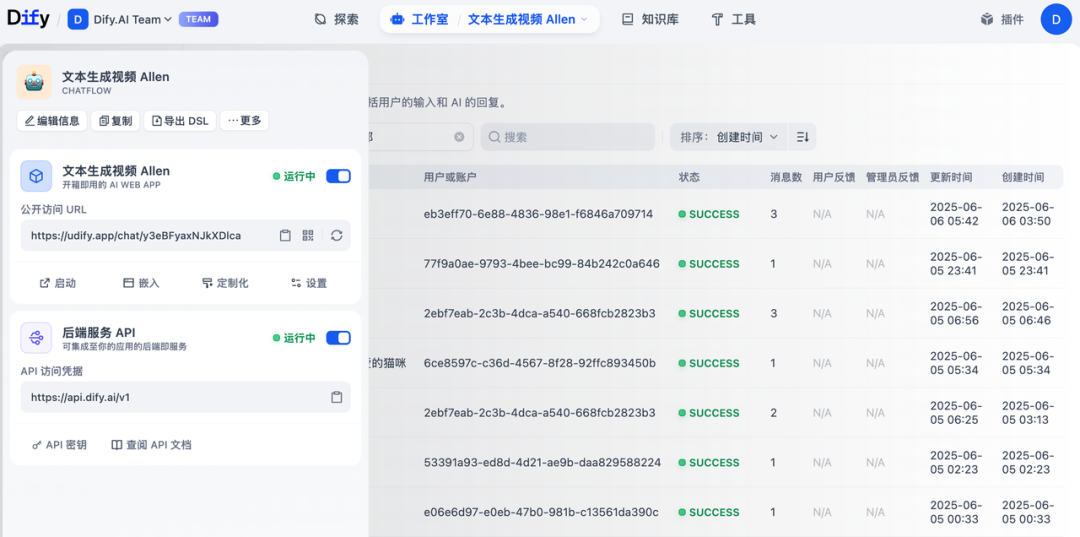
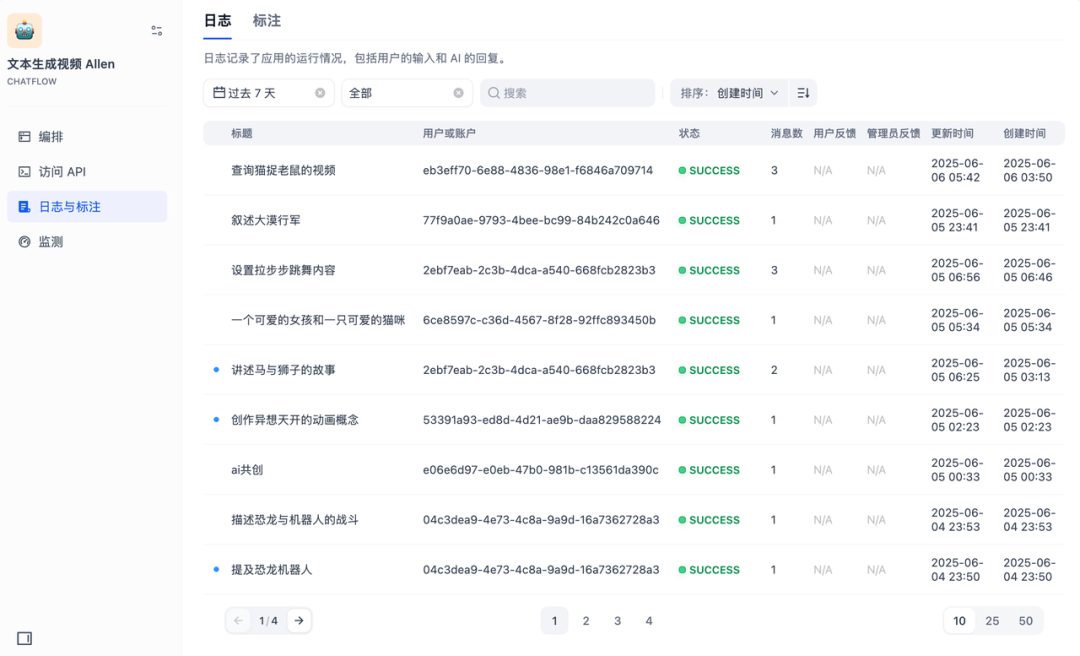
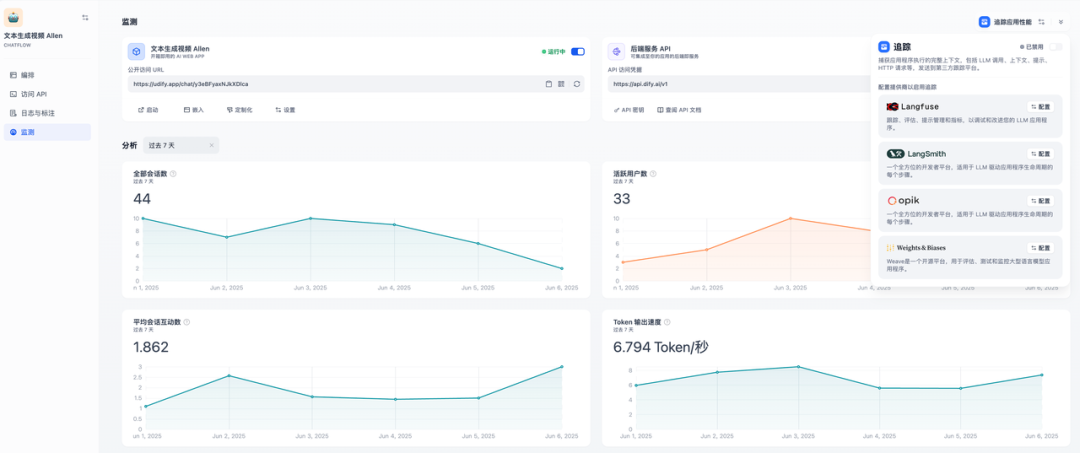
五種類のアプリタイプはすべてAPIに対応し、埋め込み用のコードが組み込まれています。ナレッジベースにもAPIがあります。オープンソースの初日から、アクセスログ、フィードバックのアノテーション、そしてセッション数、トークン速度、費用などのモニタリングが備わっています。エンタープライズ版では、より高い同時実行数とマルチテナントに対応しています。
#まとめ
AIの時代は変化が速く、チャンスもたくさんあります。Difyは「武器庫」になりたいと考えています。アイデアを持つすべての人が、その創造性を現実に変えられるように。